神奇妙妙通信小问题
记得在不久之前,有一位面试官询问我了一个问题,大意似乎如下:
你如何处理PD分离中KVcache传输、各种TP、CP通信之间互相协调的问题?
由于当时是infra 新手,再加之技术栈全点在算子方面,于是支支吾吾也不知怎么回答。如今读了一些mooncake,hicache,rdma,nccl的知识,于是尝试斗胆思考一下这个问题以防止脑子生锈,很多概念也是初次接触初次思考,感谢大家指错。
问题边界定义
假设我们有一个采用PD分离架构的LLM推理集群,具备以下条件:
- 集群由多个GPU节点构成,每个节点假设有8张GPU,intranode通过NVL互联,internode通过RDMA互联。每一个node有2个RDMA双工NIC。
- 模型规模比较大,且Prefill与Decode并不对称。在满足相应SLO条件下,4卡可作为一个Prefill节点,8卡作为一个Decode节点,且Prefill node采用TP + CP,Decode node采用TP,对于MoE来讲,两者都采用EP。集合通信除EP外都采用NCCL,EP采用megamoe。
- Prefill node完成后需要向Decode node传输KVcache,使用基于RDMA的Transfer engine例如Mooncake等,同时应用了hicache来支持对HBM、Hostmemory、SSD storage的充分利用。
- 集群同时服务多个请求,不同请求处于Prefill、KV transfer或Decode等不同阶段。为了简单起见,我们假设我们的PD配比是完美的,集群请求到达是严格稳定的。
Mooncake
先讨论一下Mooncake,Mooncake主要由Transfer Engine和Mooncake Store组成。
Transfer Engine
在mooncake-transfer-engine/src/transport中,我们可以看到巨量的transport后端:
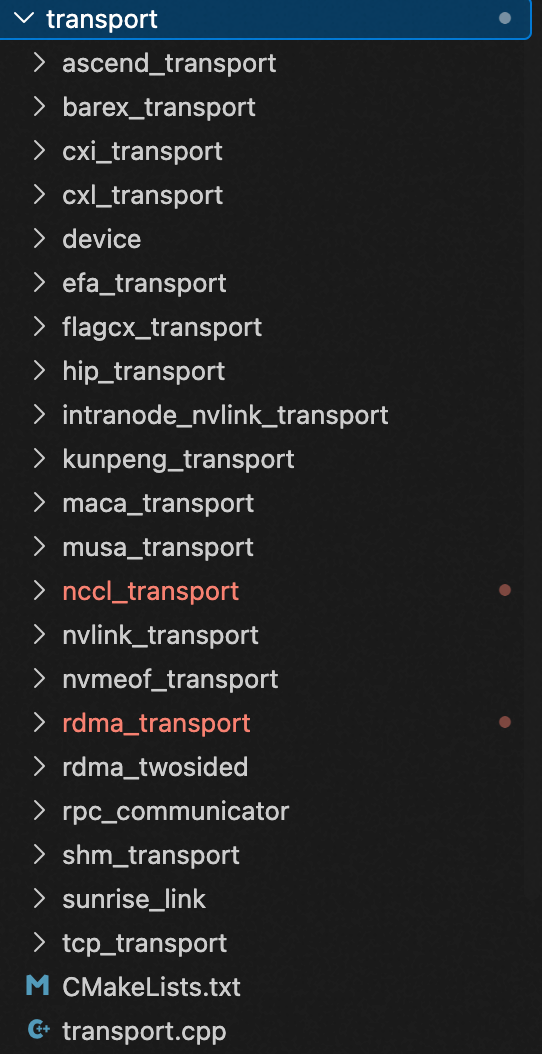
每一个transport均封装着其细节底层的实现,但是所有的transport对上层暴露出的接口只有以下几类:
install():初始化后端,接入metadata和topo(un)registerLocalMemory()让后端准备、释放对该段内存的访问allocate/freeBatchID()创建、释放一批任务submitTransfer()提交传输请求getTransferStatus()查询传输是否完成或失败getName()标识后端
在能够操控后端完成这几种通信原语之后,Mooncake便进行了进一步封装,最终得到了一个能自动选择路径、走完整个搬运生命周期的TransferEngine。
Mooncake Store
这是Mooncake为我们提供的分布式存储后端,在SGLang HiCache的分类表中,kvcache主要分为L1, L2, L3三层:
| 层级 | 缓存在哪里 | 命中后怎么办 |
|---|---|---|
| L1 | 本地 GPU 显存 | 直接复用已有 KV 块 |
| L2 | 本地 CPU 内存 | 加载到 GPU 后复用 |
| L3 | Mooncake Store | 先取到本地,再加载到 GPU |
我们可以看到,Mooncake Store主要是管理的L3缓存,在SGLang官方文档中,我们可以看到3FS、NIXL等与之相同生态位url。
因此,显然Mooncake的典型部署情景差不多就是:若干进程贡献一段CPU DRAM,组成分布式内存池。或者可以用独立存储节点来做这件事情。
因此,Mooncake Store便可以理解为:一个管理目录和空间的Master,然后加上一组贡献内存的节点,客户端根据master给的位置直接读写这些节点:
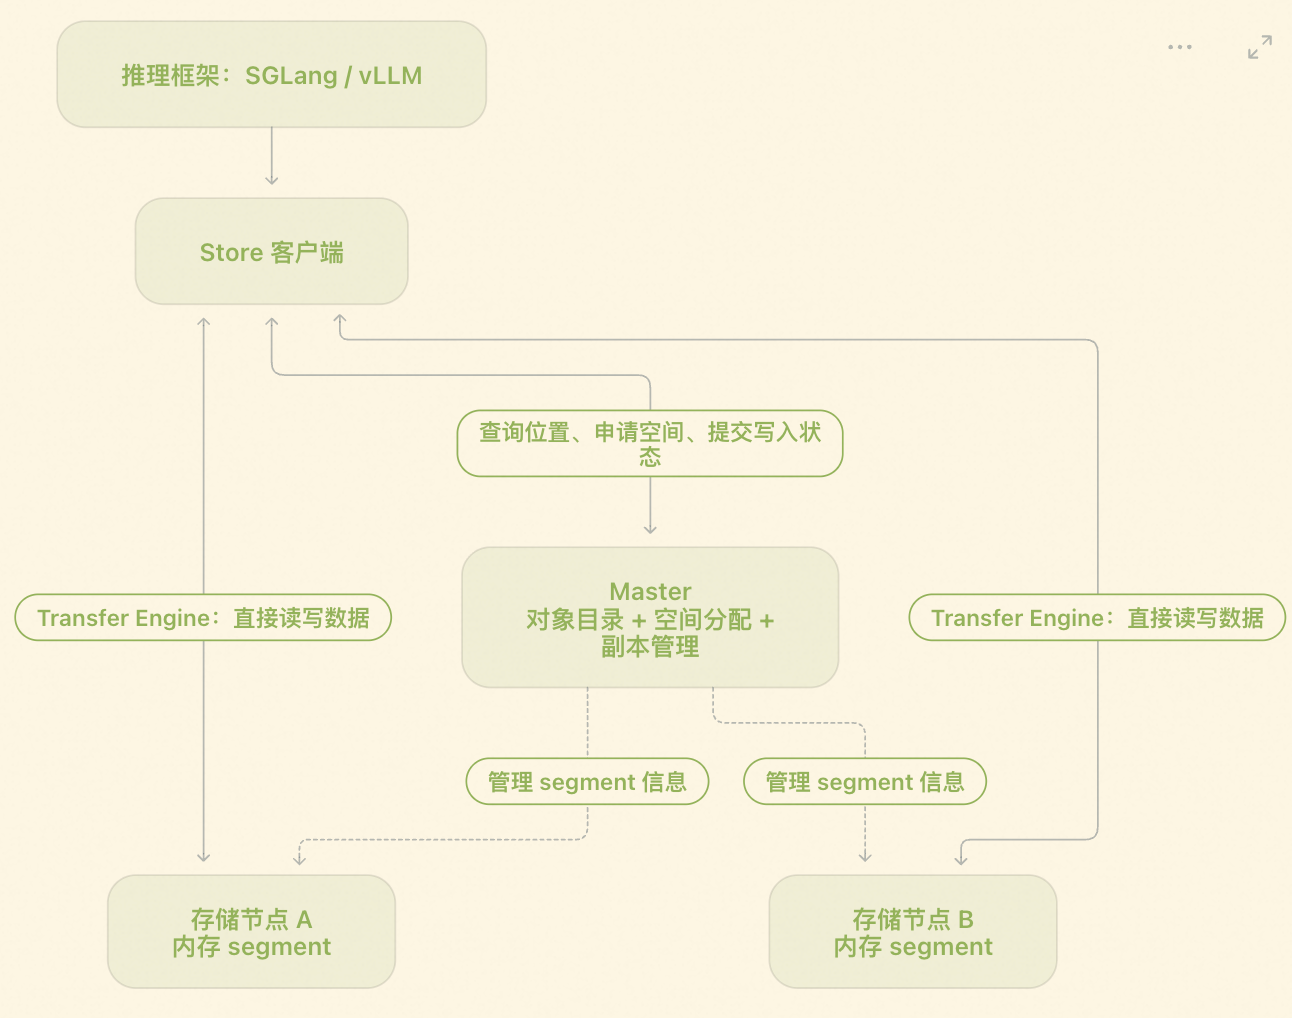
Put(key, data)- 客户端调用Master的
PutStart, master选择segment、预留空间,返回目标位置 - 客户端调用Transfer Engine,将数据写入,例如RDMA Write。
- 搬运成功之后,客户端调用
PutEnd, master感知到完成。
- 客户端调用Master的
Get(key, data)- 客户端向master查询可读副本
- 选择一个取得位置
- 调用Transfer Engine, 例如RDMA READ。
这样一来,我们就可以把KVcache管理抽象为集群中的另一套系统。在实际的应用中,我们似乎可以选择开启Mooncake Store。
如果不开启的话,那就是只有Transfer Engine:
这里有一个问题,Decode侧GPU是怎么分配出合适大小的内存并告知prefill侧呢?
观察发现,大小就是prompt length,所以是可以在prefill计算的时候完成控制面数据的交换的,并且可以严格预测prefill时间,给了我们复杂优化的可行性。
然后Prefill侧直接Write到Decode侧中,然后通过控制面发送Trans_DONE,decode便可以收到回复了。
反之,如果开启的话,也就是只多了一条缓存复用和读取路径:
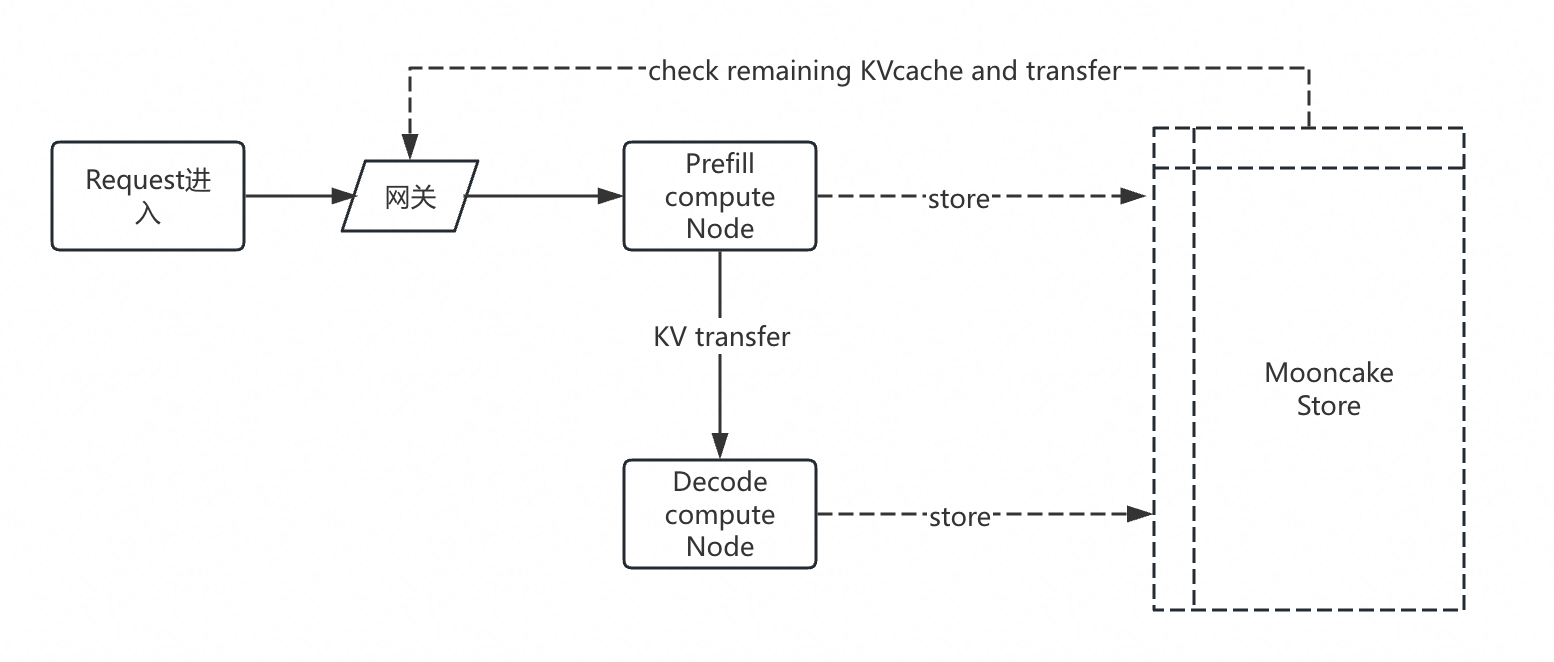
但是,如果我们使用的是Store connector的话,Decode就会与Mooncake交互以获得KVcache,显然这是不怎么合理的,浪费了overlap和RDMA write那么好的性能。
Reflection
好了,上述我们就把Mooncake的主要功能给介绍完了。但有几个问题值得我们继续思考:
- 前文说过可以把KVcache管理抽象为集群中的另一套系统,但其对集群资源的利用显然可见:
- 无论是怎样的传输都会涉及到对RDMA NIC、NVLink、PCIE的争用(PCIE: L2但是无竞争;NVLink:intranode 与 TP EP CP高竞争;RDMA NIC:internode但无竞争)
- 一些控制面数据以及poll引发CPU资源占用(牵强可忽略)
- KVcache传输是否需要prefill完全完成?这里我们显然使用chunked prefill便可实现。此外,单chunk内部也是可以逐layer计算完之后传输的,这样我们便实现了一定的overlap。
- Prefill侧和Decode侧可能面临不同的KVcache Layout问题,比如说Prefill采用了Ulyness, Decode又是什么乱七八糟的并行,这个或许需要再考虑一下,但并不是我们这次重视的问题。
- 引入chunked prefill之后是否还要考虑kvcache prefillnode长期驻存的问题?若chunked prefill,如果我们支持多request单prefill node,似乎会引入更复杂的问题。
NCCL
这里提NCCL的意图是,我们Prefill和Decode侧都存在着大量的并行通信,哎这里就不详细介绍了,反之我们都知道他们都会占用NVLink就行。
NCCL在NVLink域下会使用LL128协议,主要是通过NVLink进行 atomic 8 个相邻线程各写 16B,覆盖一条 128B 行,其中包含数据和 flag 128B写到对端,然后对端poll直至flag完整。
回归性原理
回到初始的问题上,我们明显发现,在模型推理过程中,并行通信与KVcache传输是有可能重合的,比如说我们就按照prefill过程中逐layer传输为例:
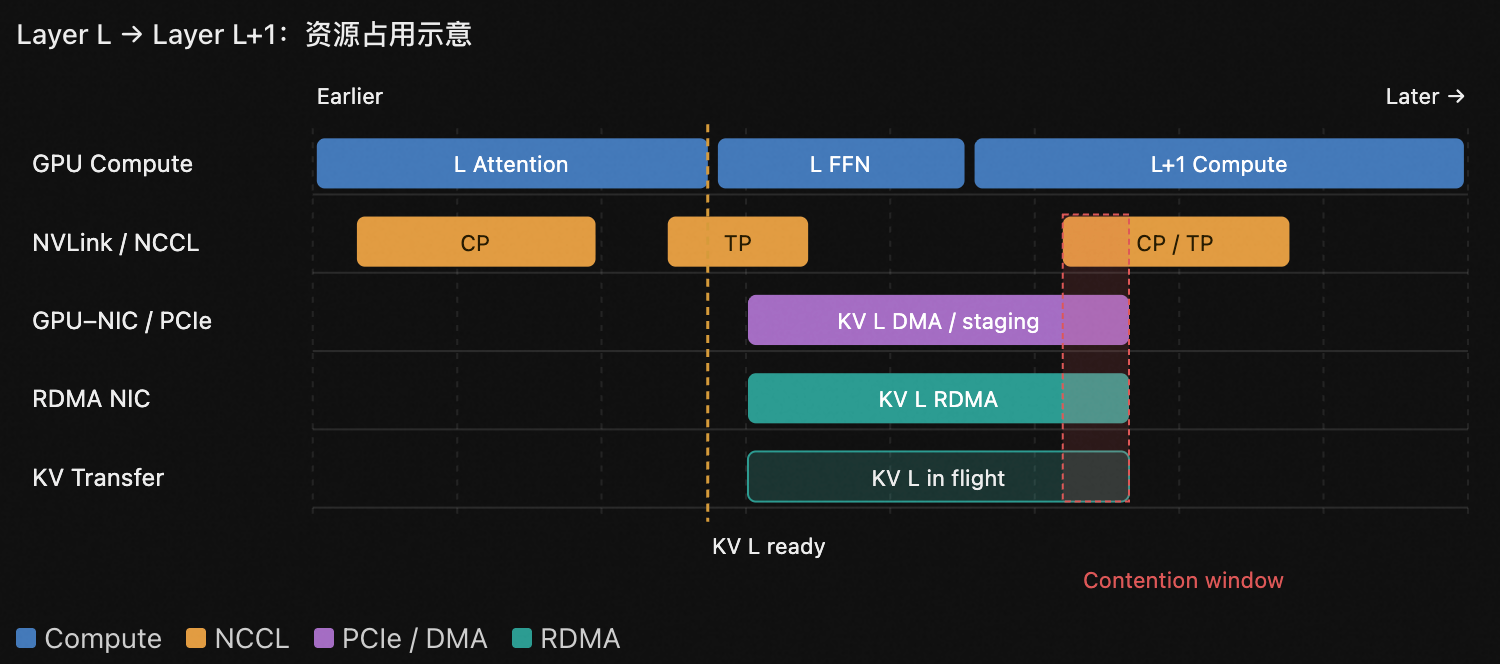
这张图里,RDMA传输会对下一个layer的通信计算,本ffn的通信计算造成阻断。但是先不要急,先考虑一个问题:KV transfer是NIC到HBM之间的通信流量,这会不会影响GPU之间的通信流量呢?
很好我查了查,发现我是傻子,RDMA NIC是通过PCIe与GPU连接的,也就是说根本不会发生通信物理链路的重合,我们只需要考虑HBM读取流量竞争问题。但是问题是HBM是足够高的带宽,所以这也不是一个问题。
啊这,那我们想讨论的问题不复存在了呢,对于decode node,他的通信也是全走的nvlink,NIC不会发生争用。
所以我们这一段的讨论是毫无价值的(x
因果性原理
话又说回来,如果我们的集群并没有NVLink,比如说使用了神奇的Pro5000/Pro6000/5090(谁家集群这么干!),这就会出现很大的问题,因为这时候并行通信是经过pcie,然后NIC也是经过PCIe,显然是更不好处理的,但是谁愿意自找苦吃呢?假如GPU0 同时执行:
此时,两条流量必须经过GPU 0 的同一个PCIe端口,这是不妙的,更准确的结论是这样:
| 互联方式 | KV Transfer 与节点内 TP/CP |
|---|---|
| NVLink + PCIe NIC | 主要是 GPU 内部资源竞争 |
| PCIe P2P + PCIe NIC,同 GPU | 直接争用该 GPU 的 PCIe 端口带宽 |
| PCIe P2P + PCIe NIC,不同 GPU | 可能共享 Switch 内部资源,但不一定争用 Link |
| PCIe P2P 不可用,走 Host DRAM | 需要进一步考虑 CPU Root Complex、Host 内存及上行链路 |
想想有什么解决办法吧,我们或许需要建立一个link contention model,然后优先保障通信计算,其次再是KVcache。
为什么呢?观察我们的三类流量:
| 流量 | 主要来源 | 调度属性 |
|---|---|---|
| TP/CP collective | NCCL | 延迟敏感,直接影响 Layer 执行 |
| MoE EP | NCCL | 延迟敏感,可能与 TP/CP 共享链路 |
| KV Transfer | RDMA | 有一定弹性,但存在完成期限 |
TP/CP/EP 属于执行关键路径,而 KV Transfer 在一定条件下可以提前执行、延迟执行或者限流。于是我们尝试建模:
对于一个 PCIe port ,假设我们预测未来一段时间内 TP/CP/EP 的带宽需求为:
该端口的有效带宽上限为 ,那么可以分配给 KV Transfer 的剩余带宽是:
那对于一条 KV Transfer 路径 ,它的有效可用带宽近似为:
这里要注意,实际 PCIe 通信是有向的,因此每个端口的发送与接收方向应该分别建模。而且我们不必要求 KV Transfer 与 NCCL 分时,而是采用以下规则:
- NCCL 不活跃时,让 KV Transfer 尽可能使用剩余带宽。
- NCCL 活跃但尚有带宽余量时,允许 KV Transfer 继续执行。
- NCCL 对共享端口产生严重竞争时,降低 KV Transfer 的注入速率。
- KV Transfer 接近 deadline 时,允许一定程度的资源竞争,权衡 Decode stall 与 Prefill slowdown。
然后或许通过乱七八糟的建模,我们可以定义transfer的紧迫程度巴拉巴拉,然后得到一个好的优化目标和策略,然后我们又能宣称我们做了什么什么优化。
不过这个优化一看就是那种没什么必要的优化,不过看上去像是免费的午餐,但是很难想到一个pcie机器会需要这样的优化,成本有点难收回来。但是这token用着不烧心doge。
题外话
文章第一段讨论了mooncake的一个思路,主要是围绕着PD分离的场景做了很多适配和合理的优化,但是最近手上在做的一个工作给了我更多的想法。
在传统PD分离场景中,Prefill和Decode是两个角色,两者分别是compute bound和memory bound,由此也衍生了不同的优化方法,such as prefill甚至不开cuda graph,decode上高带宽机器等等。但是无论如何,decode与prefill的计算路径不会发生改变(mtp除外)。
但是,Deepseek v4.1flash的发布让我们认识到了原来prefill可以只做前二十层的,说白了prefill就是产生第一个token和产生kvcache的,那此时便有了一个问题,我们在prefill节点上只进行前20层,然后将kvcache和中间激活值传给decode节点,然后只让decode去过剩下那20层,是否可以呢?
想法很丰满,现实很骨感,注意到Deepseek使用的是CSA2 + SWA结构,这代表着第一个经过后20层的token必须要在每层有上128个token的kvcache,这代表着我们实际上不能直接把最后一个token算出来然后送给decoder。
倘若我们选择让decoder重建的话,那decoder会时不时地收到一个request,带着之前的128token,要求全跑一遍(你是什么奇奇怪怪的人啊)。这当然是可以做的,但是问题是,这会造成decode时不时的卡顿,这与我们做pd分离的初心相悖(前几天去了解史料发现当时chunked prefill与pd分离打得挺激烈的,批评chunked prefill也有很大部分是批评用户体验)。
那怎么样去解决这个问题呢?如果把这128个token放到prefill侧,那需要在所有的token进行完前20层之后,再单独给后128个token进行一个后20层,这显然会引入bubble,而且挺明显的。
不知道deepseek是怎么推的这个模型,或许还可以引入一个新的角色,叫做什么reconstruction role,专门处理prefill这种尾部问题,然后与prefill可以多对一,且在第二十层之后prefill可以先发128个token到一个recon 节点上,但是这个recon节点又是需要所有的第20层kv cache,感觉对网络需要也蛮高的,不知道有什么好的处理手段。
Epilogue
OK,本文首先梳理了mooncake的结构,然后探讨了kvcache传输与通信之间的网络争用问题,最后又想了想deepseek该怎么推的问题。基本上就到这里结束,思考如有错误请大家指出见谅。思考还是不充分啊