KV Size on sm10+
我们先看看当下流行的模型结构:
Deepseek v4.1
Encoder Decoder结构,后20层复用kv20,使用kv_oprojection进行低秩分解。分析其per token KV:
其kv设计为kv_source_layer_ids = [2, 8, 14, 20],前三个的压缩比为2,后一个的压缩比为1。基于model arch head_dim=512可得:
前3个source均为2:1 compression,因此一个token而言是:
此外,对于reuse mode CSA而言,我们还需要保留indexer,而indexer的dim为128,切只有kv_source_layers才拥有该k_cache,但是值得注意的是其似乎采用了mxfp4类型的量化:
继续压缩:
因此
Deepseek v4 Flash
HCA与CSA交替,compress ratio为CSA4,HCA 128。我们看到v4里面实际上是:
对于main KV:
而真实KV 512dim中:
因此main KV为:
然后对于CSA的K indexer:
而CSA pertoken数量大概是:
然后我们高兴地加起来,大致是
GLM 5.3
据说glm的模型是在deepseek v3.2的基础上训出来的(x
组成一个glm layer block的基元差不多如下:
然后这样的层数有78层,大致如下:
1 | L0 full |
去看config,大概是21 Full indexer layers, 57 shared layers,所谓share是share DSA的 topk index。
对于BF 16 cache,每一层的MLA KV大致为:
然后我们统计indexer K:
调查一下发现大家都用fp8来存这个kvcache。我们进一步精细算一下:
对于indexer:
因此
这也太大了….
GLM 5.3 Flash
看上去是一个缝缝补补的架构:
也就是MLA需要KV cache,值得注意的是采用了Sparse MLA, 仍然是采用了indexer的设计,MLA的设计是这样的:
然后对于indexer:
比较像QSA,算一下KV cache的大小:
然后对于indexer:
因此加起来差不多是:
kimi K3
我们继续研究kimi K3,与上文的大多数模型不同,kimi k3使用了hybrid linear attention:
也就是一个
的设计。
对于KDA这种linear attn,其就像LSTM一样并没有KV cache,取而代之的是一个S吸收矩阵(真的合理吗)。对于这个Recurrent State,其大小为:
这个值也不随context lenth增长,于是我们只去讨论Gated MLA
值得注意的是,苏剑林明确说K3 摒弃了Rope,所以后面这64维更像历史遗留。
因此我们现在来计算真正增长的KV:
Qwen 3.8 2.4T A95B
其核心结构大致为:
GDN与KDA是相似的linear attention,我们就不需要管了,也就是我们现在只需要计算Gated Full Atention就行。
但是这甚至更原始,我去我都以为GQA消失了,但是我们的qwen居然是一个GQA:
因此其KV cache计算也就是:
若是采用fp8 kvcache,也就是:
Qwen 3.8 27B Dense
其核心结构大致是:
依旧是GQA:
也就是:
Qwen3.8 next
在qwen 4的early preview中,我们可以看一眼下一代qwen 模型的架构:
GDN与之前相同,我们来看看QSA。
但是现在很有趣的是QSA也采用了indexer的想法, indexer的参数是:
对于每一个token先产生一个k,然后每4个token去做一次AvgPool。
好现在我们就可以来算一下了:
对于indexer:
因此,如果直接用fp8来存储的话,大概是:
Hunyuan 4 preview
这个和glm5.3一模一样。
epilogue
因此,我们最后的图片大概这样:
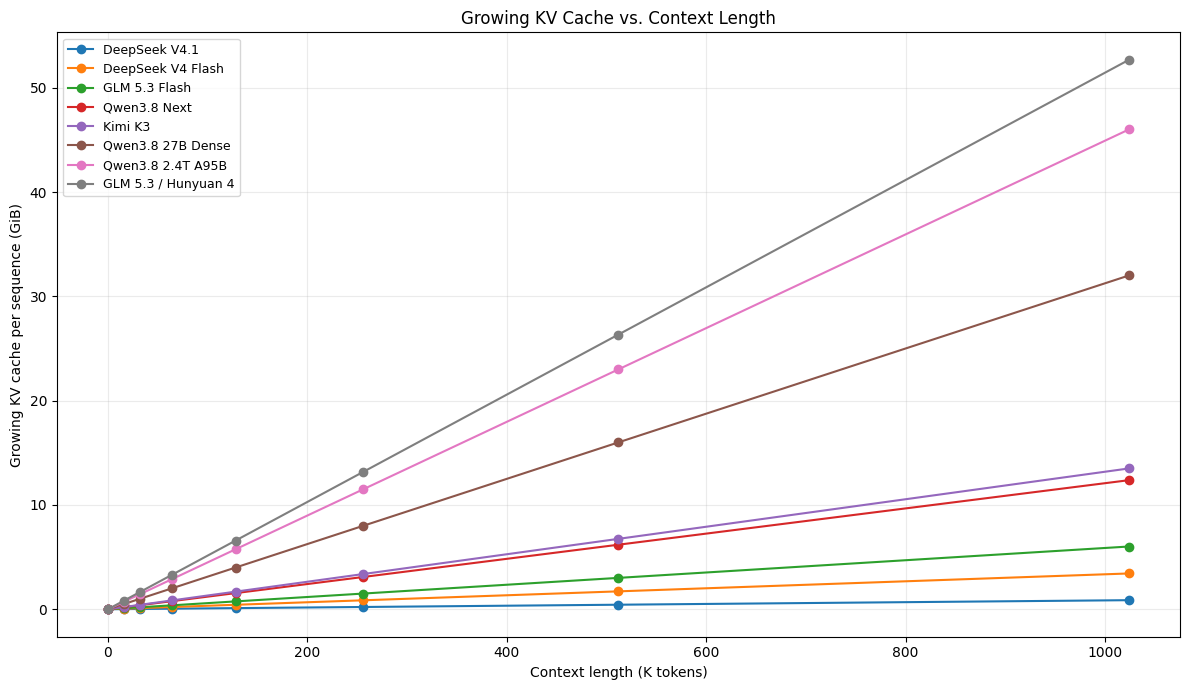
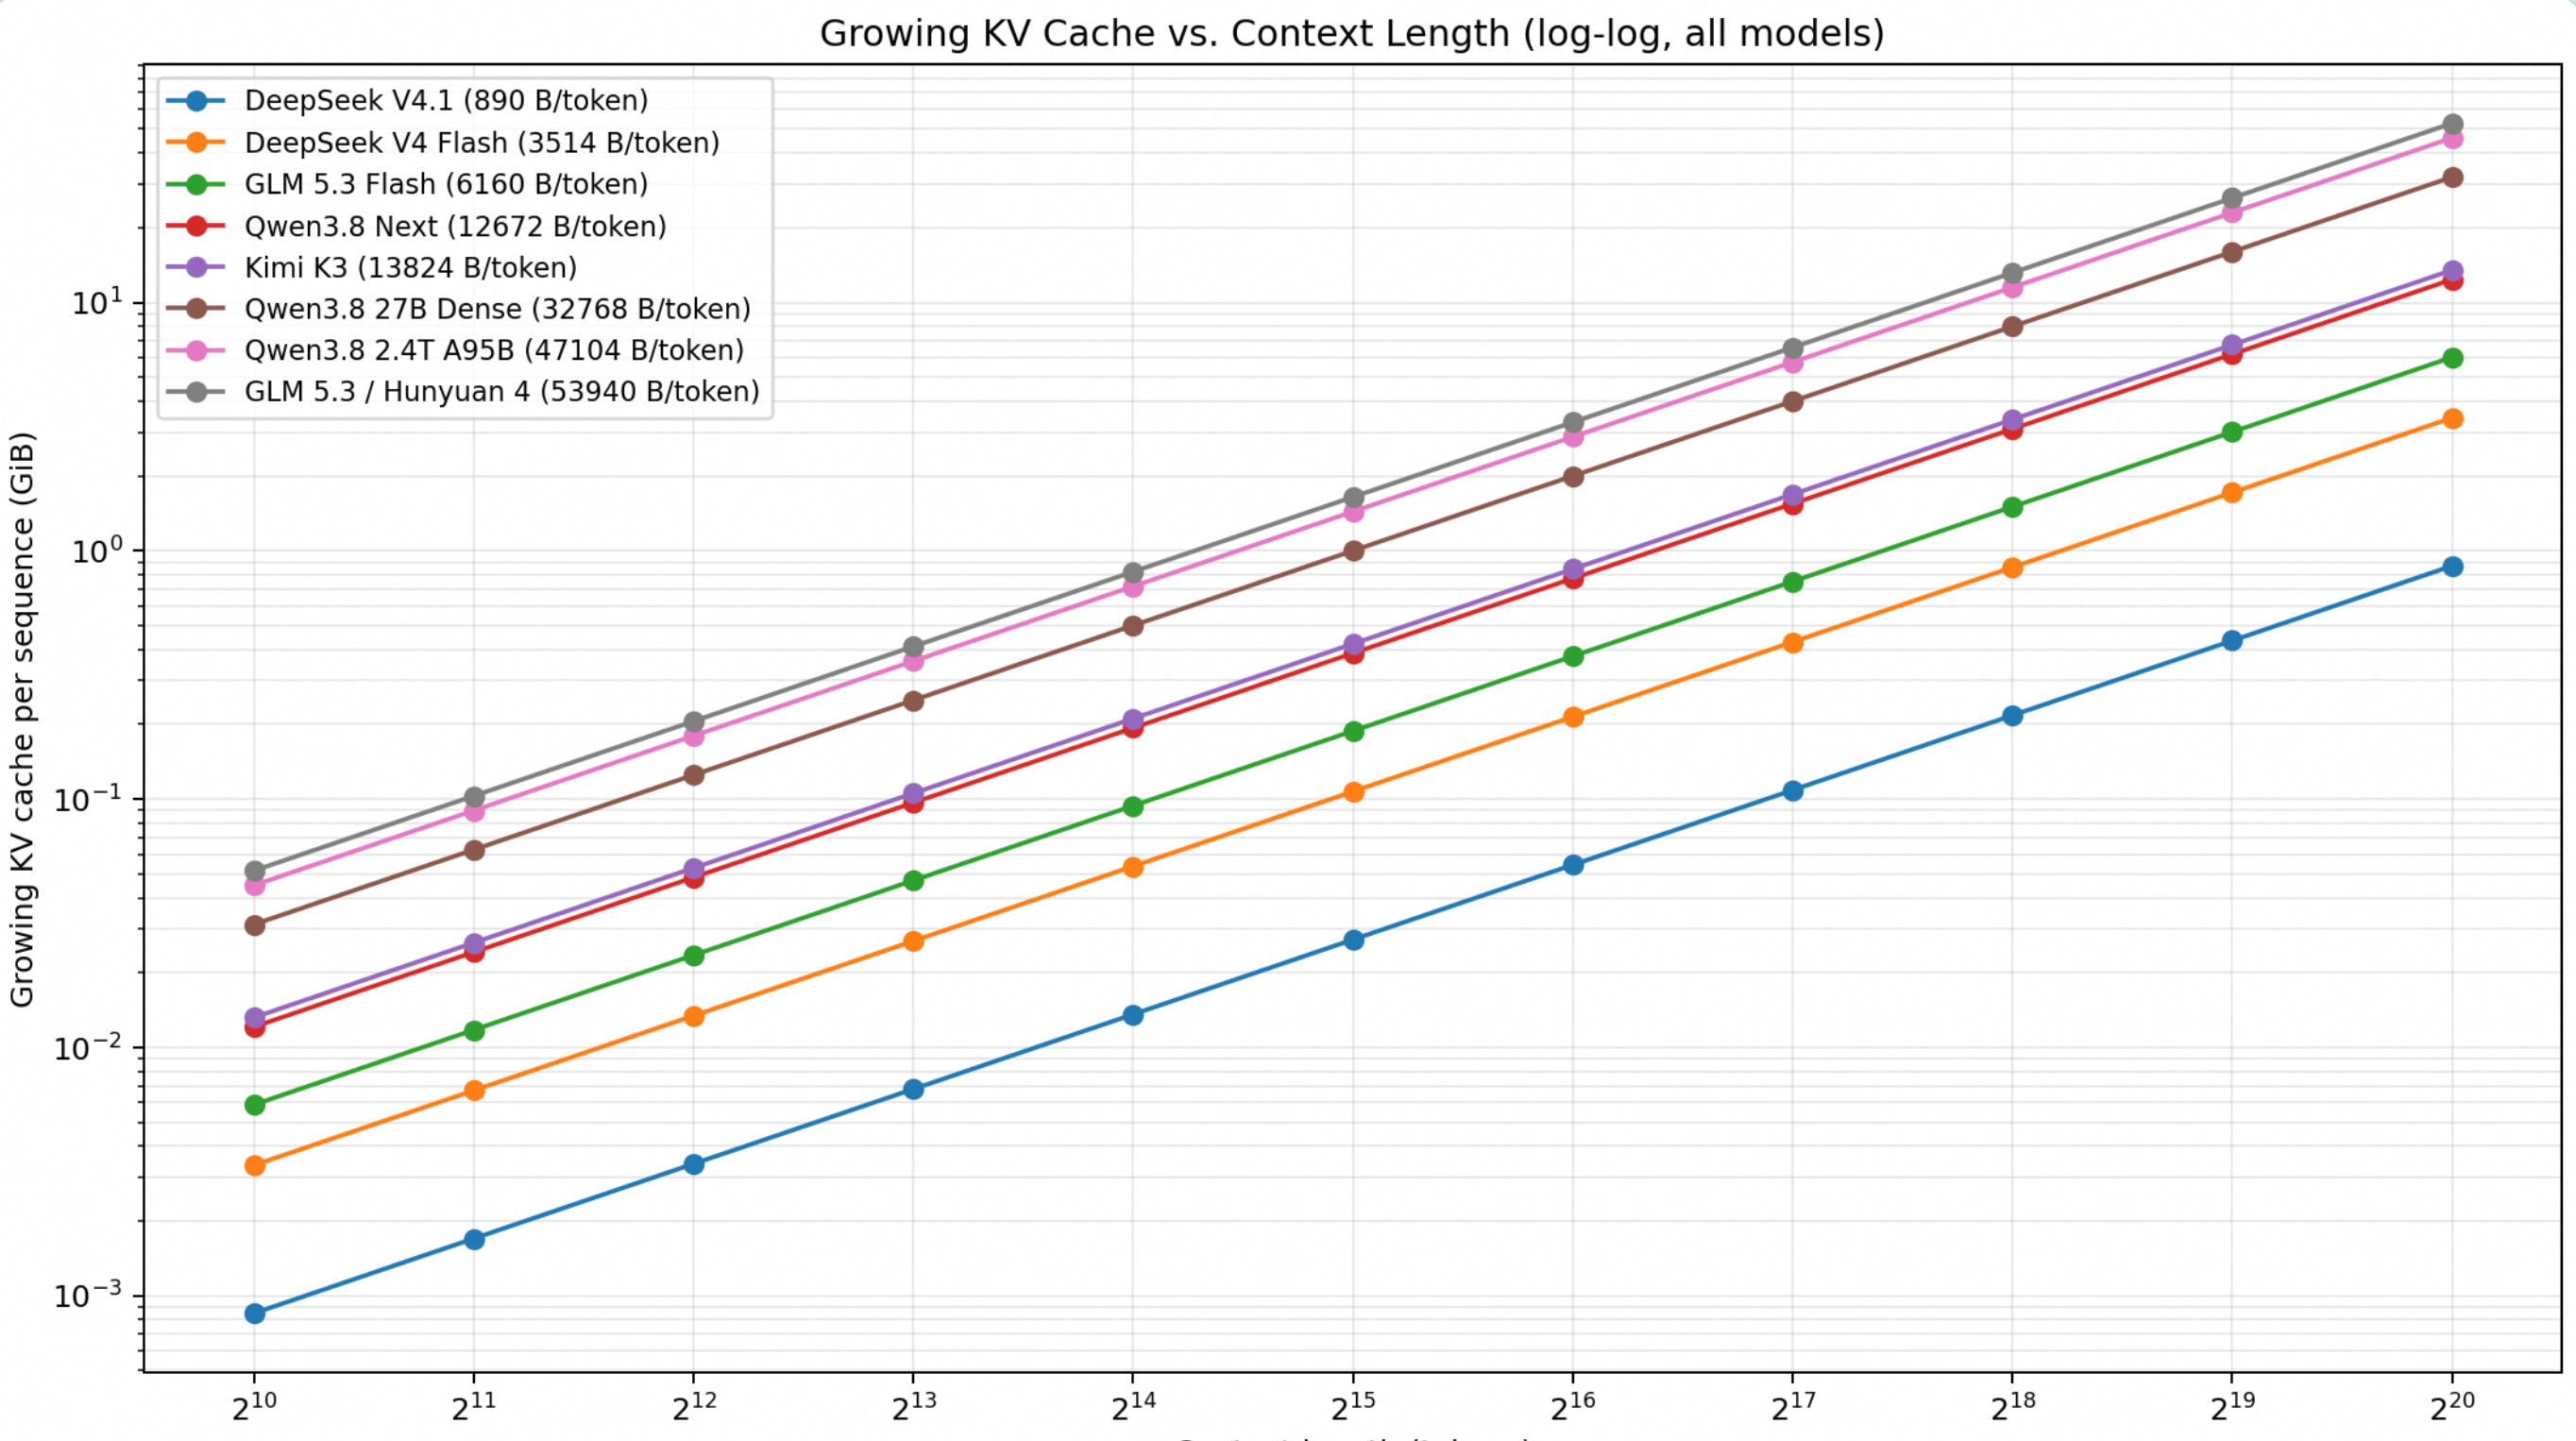
| Model | Attention / KV design | Cache precision used | Growing cache (B/token) | Growing cache (KiB/token) | 1M context (GiB) |
|---|---|---|---|---|---|
| DeepSeek V4.1 | CSA2, cross-layer KV reuse + sequence compression | FP4 Main KV + FP4 Indexer | 890 | 0.87 | 0.87 |
| DeepSeek V4 Flash | 21 CSA + 20 HCA, compressed KV | FP8/BF16 Main KV + FP4 Indexer | 3,514 | 3.43 | 3.43 |
| GLM 5.3 Flash | 34 KDA + 11 Sparse MLA, kpool=4 |
FP8 Main KV + FP8 IndexPool | 6,160 | 6.02 | 6.02 |
| Qwen3.8 Next | 36 GDN + 12 QSA, 4:1 pooled Indexer | FP8 GQA KV + FP8 Indexer | 12,672 | 12.38 | 12.38 |
| Kimi K3 | 69 KDA + 24 Gated MLA | FP8 MLA KV | 13,824 | 13.50 | 13.50 |
| Qwen3.8 27B Dense | 48 GDN + 16 Gated GQA | FP8 GQA KV | 32,768 | 32.00 | 32.00 |
| Qwen3.8 2.4T-A95B | 69 GD N + 23 Gated GQA | FP8 GQA KV | 47,104 | 46.00 | 46.00 |
| GLM 5.3 | 78 MLA + DSA, 21 Full Indexer | FP8 MLA latent + BF16 RoPE + FP8 Indexer | 53,940 | 52.68 | 52.68 |
| Hunyuan 4 Preview | 78 MLA + DSA / IndexCache | FP8 MLA-like optimized layout | 53,940 | 52.68 | 52.68 |
KV Size on sm10+