从 NCCL Ring LL 到 PCIe IPC AllReduce
最近在读NCCL相关内容,对LL协议产生了诸多兴趣,恰好在做deepseek v4.1 flash serving on 8xpro5000时,使用的NCCL Ring LL kernel被flashinfer PCIe IPC kernel完全打败(7x对比)。于是想要去研究一下NCCL在这个过程中的具体行为。
Traditional LL Protocols
拜读完NCCL经典论文Demystifying NCCL: An In-depth Analysis of GPU Communication Protocols and Algorithms之后,文中提到的NCCL Communication protocols主要有以下3种。
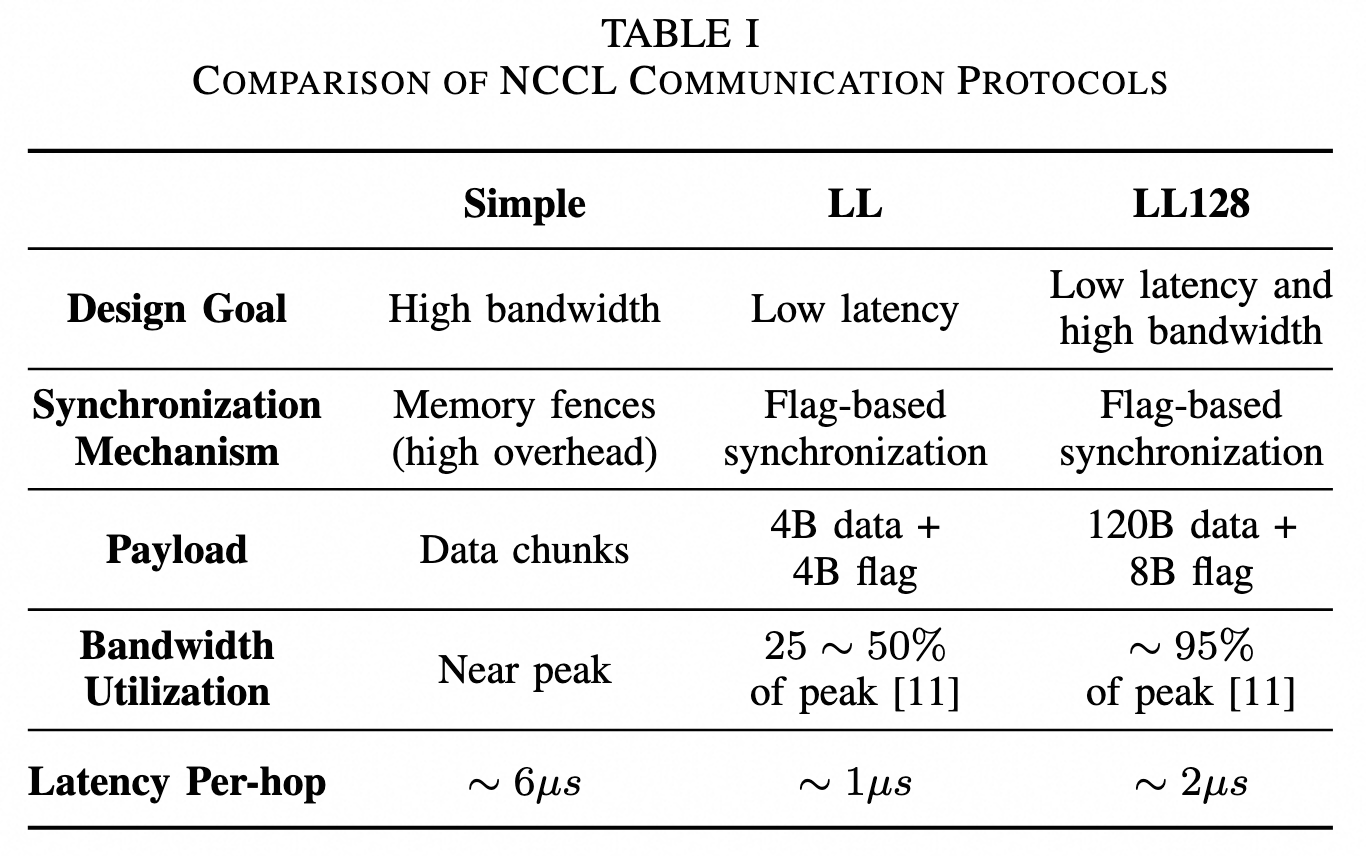
- Simple: 大块的数据被分到多个channel中,但是需要memory fence保证memory consistency,延迟不够友好,但是带宽利用极佳,且支持P2P,不经过CPU path。
- LL:传输的数据layout为:[4B data | 4B flag],因此带宽最高也就只能达到50%。在论文撰写的时候,也就是2.19.1版本中,GPU将8B line写入到CPU buffer memory中,然后CPU poll flag,之后通过NIC发送。显然这样的实现不支持send侧的GDRDMA。因单条数据很小,因此latency最低。
- LL128:传输的数据layout为:[120B data | 8B flag],一般通过NVLink传输。在send GPU侧积攒了一个chunk之后可通过NVL传输,是Simple与LL的结合版。但是因为flag需与data保持在一个packet里,所以需要支持atomic 128B writes,这是其使用NVLink的主要原因。
对于Protocol的选择上,既可以通过用户自己选择:NCCL_PROTO,也可以进行自动选择,由system topology, GPU architecture, message size和predefined performance metrics等决定。
LL Protocol’s problem and solutions
由上文所述,LL的实现是绕不开CPU memory的,即使在NVLink环境下,LL协议的路径也基本上是如下所示:
但在后续的NCCL的不断发展中,NCCL引入了Symmetric Memory、LSA、GIN等新的特性(NCCL 2.28.7),逐渐让我们看到了LL绕开host mem的新做法。
Symmetric Memory
所谓Symmetric Memory,其与NVSHMEM高度相似(怀疑其就是一个东西),主要思想就是在一个通过NVLink互联的domain内,得益于NVL72高达1800GB/s的双向互联带宽和极大的并行域,使得过去必须通过NIC进行的一些通信,现在可以在一个统一的NVLink domain内完成。
而通过NVLink互联的GPU通常具备P2P direct能力,主要是利用了CUDA的VMM特性,local GPU可以将远程GPU的HBM映射到自己的内存空间中。
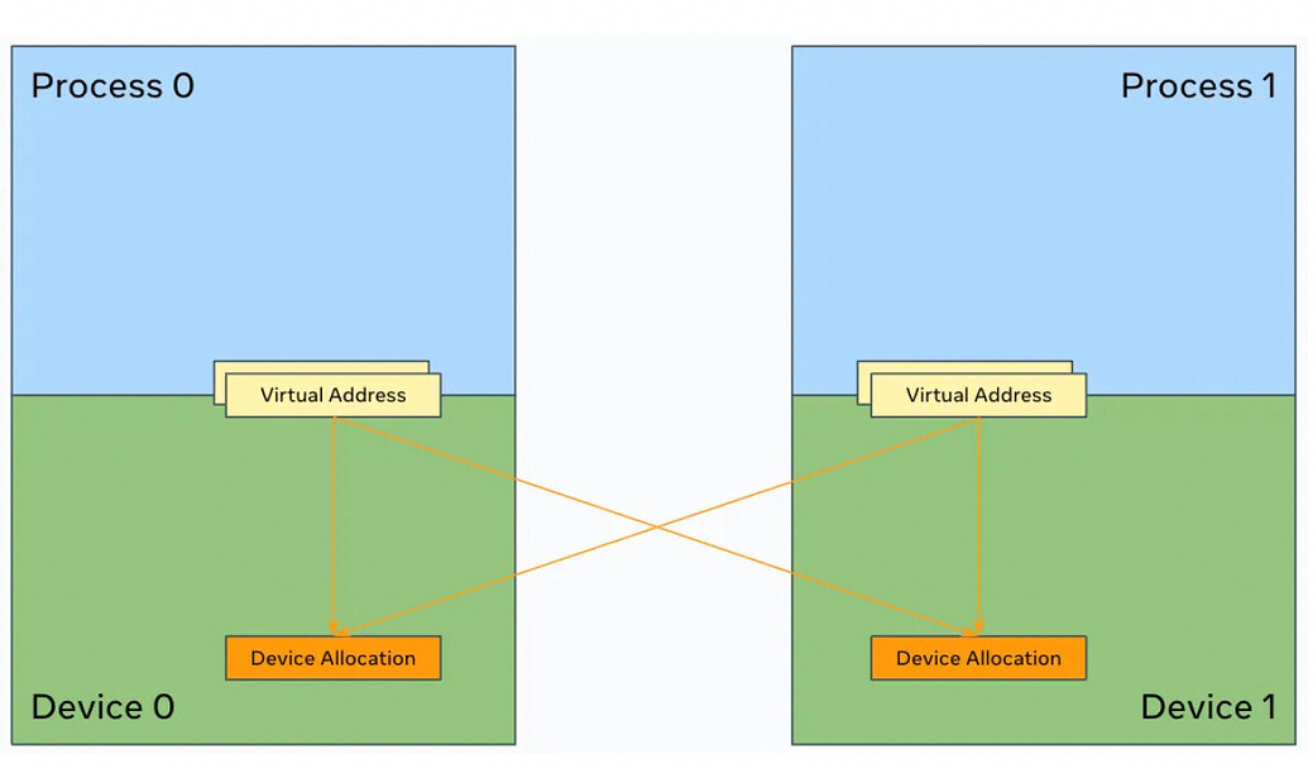
映射完成之后,local GPU的kernel就可以通过正常标准的指令直接进行读写,硬件自动处理通过NVLink的请求,对cuda kernel来说是无感的。
建立在以上的硬件基础之上,在 2.28中,NCCL 构建了一个基于CUDA VMM构建的、为节点内所有GPU提供统一、扁平化、对称虚拟地址空间的底层基础设施,来实现 Symmetric Memory 的设计。简单来说,其提供了一个严格对称的内存空间,对称堆的分配是集体操作,要求所有 GPU 步调完全一致。
LSA
Load/Store Accessible模块,每块GPU都能获得其他GPU内存的直接指针,这意味着在机内recv侧GPU的kernel可以直接在显存中poll send侧的Flag,Send侧的GPU也可以直接执行8B atomic write到recv侧显存,这个过程完全消除了host memory的参与,从而消除了跨PCIe的延迟和data copy到host mem上的开销。
GIN
GPU-Initiated Networking模块允许GPU直接与NIC交互。kernel直接将WR写入NIC启动RDMA,通过ncclGin_Put / ncclGin_Get读写远程 GPU 内存,ncclGin_SignalAdd:原子增加远程信号,用于同步。
因此,通过以上技术的支持,LL Protocol直接摆脱了CPU侧的通知开销,实现了更快更低延迟的通信流。
Pro5000 ?
上面洋洋洒洒讲了一大堆NVLink域内的LL改进路线,但是实际的场景是在一个2xNUMA domain,且每domain内的4张pro5000位于不同的PCIe bridge内的复杂环境中进行通信。所有的NCCL通信都发生在同一个NUMA domain里。
在一开始,提取kernel timeline的时候发现使用的是ncclDevKernel_AllReduce_Sum_bf16_RING_LL,发现其性能数字如下:
| Input Size per rank | NCCL SHM/direct |
|---|---|
| 10KB | 20.647 |
| 20KB | 21.093 |
| 40KB | 22.568 |
| 80KB | 22.993 |
| 160KB | 31.282 |
| 320KB | 48.683 |
查阅源码,其LL读写行为是发送 GPU 用 st.volatile.global.v4.u32 写入到LL FIFO;接收 GPU 用 ld.volatile.global.v4.u32 反复读取,直到两个 flag 都匹配当前 step,才使用同时读到的数据。而检查我们的NCCL配置,发现采用的是SHM/direct/direct配置,如此LL FIFO便位于GPU可访问的 host shared memory。
尝试将配置改为P2P/CUMEM,发现取得了巨大的性能提升:
| Input Size per rank | NCCL P2P/CUMEM |
|---|---|
| 10KB | 10.405 |
| 20KB | 11.204 |
| 40KB | 11.374 |
| 80KB | 12.379 |
| 160KB | 16.985 |
| 320KB | 28.505 |
这个配置的GPU行为顾名思义,初始化映射时,GPU1分配接收FIFO buffer,通过cuMem使得GPU0 process获取该buffer指针。之后GPU0的SM直接写入到GPU1 FIFO中,GPU1的SM则轮询本地FIFO,这样的话FIFO直接位于recv侧,通过实测得到的性能确实比SHM/DIRECT快很多。
偶然间,落叶捎来讯息,FlashInfer中或许有更快的做法,于是派出codex一番查找,果不其然!
| Input Size per rank | FLASHINFER IPC |
|---|---|
| 10KB | 2.957 |
| 20KB | 3.611 |
| 40KB | 4.046 |
| 80KB | 4.743 |
| 160KB | 7.190 |
| 320KB | 12.951 |
调查该kernel的行为,发现相比于NCCL有了很大的不同:
以Input size = 160KB为例,将每张卡的输入都分为A、B、C、D四段,然后进行以下的操作:
各卡的 A 段 → GPU0 收齐并求和 → 把结果 A 发给其他三卡
各卡的 B 段 → GPU1 收齐并求和 → 把结果 B 发给其他三卡
各卡的 C 段 → GPU2 收齐并求和 → 把结果 C 发给其他三卡
各卡的 D 段 → GPU3 收齐并求和 → 把结果 D 发给其他三卡
其直接摒弃了Ring算法,在数据传输协议上采用了类似于P2P/CUMEM的做法,看上去更加快速,但是值得注意的是,其每张卡上实际上承载了4倍的显存容量,是一种用带宽+显存换复杂度的做法。这不禁让我们想起了基于NVSHMEM的One Shot All reduce,存在在大消息下总通信量较高的问题,我们尝试把input拉大,虽然IPC采用了分时RS/AG来缓解,但仍出现了一些性能退化,但在目前的特定的任务场景中表现很不错。
Conclusion
本文主要是在优化特定场景中model decode中遇到NCCL性能问题之后,去读Demystifying NCCL: An In-depth Analysis of GPU Communication Protocols and Algorithms还有一些相关文章了解NCCL机制和协议而撰写的记录,感觉通篇下来并没有什么非常有意义的发现,也灌了好多水,表述也不算明晰,逻辑也不太顺畅,权当是冲10月份blog kpi得了(x
Reference
https://zhuanlan.zhihu.com/p/1951302137012295637
https://zhuanlan.zhihu.com/p/1954144890033242869
https://zhuanlan.zhihu.com/p/2038378833183822600
https://github.com/NVIDIA/nccl/blob/v2.29.7-1/src/transport/
从 NCCL Ring LL 到 PCIe IPC AllReduce
https://hjcheng0602.github.io/blog/From-NCCL-Ring-LL-to-PCIe-IPC-AllReduce/